k-Means
Gambaran singkat
Apa ini? k-Means adalah algoritma klastering paling populer. Kita menentukan jumlah kelompok \(k\), lalu algoritma mencari "titik pusat" tiap kelompok.
Analogi
Anda ingin membangun 3 warung di sebuah kota agar warga tidak jauh berjalan. Mula-mula warung ditaruh sembarang. Tiap warga memilih warung terdekat. Lalu warung dipindah ke tengah-tengah para pelanggannya. Warga memilih lagi, warung pindah lagi, dan seterusnya sampai posisinya tidak berubah. Warung adalah pusat klaster (centroid), warga adalah data.
Mengapa penting? k-Means cepat, mudah dipahami, dan hasilnya mudah dijelaskan lewat pusat tiap kelompok. Karena itu algoritma ini biasanya menjadi percobaan pertama.
Yang akan dipelajari, berurutan:
- Cara kerja: tetapkan titik ke pusat terdekat, lalu perbarui pusat.
- Apa itu inertia, ukuran seberapa rapat anggota terhadap pusatnya.
- Mengapa hasil bisa berbeda tiap kali dijalankan, dan cara mengatasinya.
- Kapan k-Means gagal, yaitu saat bentuk kelompok bukan bulat.
Istilah awal:
| Istilah | Arti sederhana |
|---|---|
| \(k\) | Jumlah kelompok yang kita minta |
| Centroid | Titik pusat (rata-rata) suatu kelompok |
| Inertia | Total jarak kuadrat semua titik ke pusat kelompoknya; makin kecil makin rapat |
Tujuan pembelajaran
- Menjelaskan algoritma k-Means dan fungsi tujuannya (inertia).
- Menafsirkan pusat klaster dalam satuan asli.
- Memahami sensitivitas terhadap inisialisasi dan asumsi bentuk klaster.
Intuisi
k-Means membagi data menjadi \(k\) klaster, masing-masing punya pusat (centroid). Cara kerjanya (algoritma Lloyd):
- Mulai: pilih \(k\) titik awal sebagai pusat.
- Tetapkan: tiap titik masuk ke klaster yang pusatnya paling dekat.
- Perbarui: pindahkan pusat ke rata-rata posisi anggotanya.
- Ulangi langkah 2 dan 3 sampai pusat tidak bergerak lagi.
Tujuan akhirnya membuat anggota sedekat mungkin dengan pusatnya. Ukurannya disebut inertia, yaitu jumlah kuadrat jarak setiap titik ke pusat klasternya (makin kecil makin rapat):
\(C_c\) adalah anggota klaster \(c\) dan \(\mathbf{\mu}_c\) pusatnya. Rumus ini hanya menjumlahkan "jarak ke pusat" di seluruh klaster.
Catatan penting. Algoritma bisa berhenti di hasil yang cukup baik tetapi bukan yang terbaik (optimum lokal), sehingga hasil bergantung pada titik awal. Dua pengaman: k-means++ memilih pusat awal yang saling berjauhan, dan n_init mengulang seluruh proses beberapa kali lalu mengambil hasil dengan inertia terkecil.
| Aspek | Keterangan |
|---|---|
| Kelebihan | Cepat, sederhana, skalabel, mudah ditafsirkan lewat pusat |
| Keterbatasan | Harus menentukan \(k\); mengasumsikan klaster bulat dan berukuran mirip; sensitif pada outlier dan skala |
| Hyperparameter penting | n_clusters, n_init, init |
| Praproses | Scaling wajib |
Implementasi langkah demi langkah
Wine terstandardisasi (k=3), lalu uji inisialisasi dan data bulan sabit sintetis untuk memperlihatkan keterbatasan. Program examples/clustering/kmeans.py; program lengkap ada di akhir bagian ini.
Langkah 1: standardisasi dan k-Means
Tujuan. Mengelompokkan 178 anggur menjadi 3 klaster tanpa memakai label.
| Kode | Penjelasan |
|---|---|
scaler = StandardScaler().fit(X); Z = scaler.transform(X) |
Standardisasi seluruh fitur. Pada klastering semua data dipakai (tidak ada pembagian latih/uji), sehingga scaler cukup dipelajari dari data yang sama; objek scaler disimpan agar pusat klaster nanti dapat dikembalikan ke satuan asli. |
KMeans(n_clusters=3, init="k-means++", n_init=10, random_state=SEED) |
3 klaster; init="k-means++" memilih pusat awal yang tersebar; n_init=10 mengulang seluruh algoritma 10 kali dari titik awal berbeda dan mengambil hasil dengan inertia terkecil. |
.fit(Z) |
Menjalankan algoritma. Hanya fitur Z yang diberikan; tidak ada y. |
km.labels_ |
Nomor klaster (0, 1, 2) tiap sampel. |
np.bincount(km.labels_) |
Jumlah anggota tiap klaster. |
km.inertia_ |
Jumlah kuadrat jarak titik ke pusat klasternya. |
Hasil. Tiga klaster berukuran 65, 51, 62 dengan inertia 1277,9. ARI terhadap kultivar 0,897: pengelompokan hampir identik dengan kultivar yang tidak pernah dilihat algoritma.
Langkah 2: pusat klaster dalam satuan asli
| kmeans.py | |
|---|---|
km.cluster_centers_ berada pada skala terstandardisasi sehingga sulit dibaca. scaler.inverse_transform(...) mengembalikannya ke satuan asli, lalu DataFrame(..., columns=X.columns) memberi nama kolom.
Pusat klaster (satuan asli):
    alcohol  flavanoids  proline
0    12.25        2.05   510.17
1    13.13        0.82   619.06
2    13.68        3.00  1100.23
Interpretasi. Klaster 2 beralkohol tinggi (13,68), berflavanoid tinggi (3,00), dan berprolin tinggi (1100); klaster 1 berflavanoid rendah (0,82); klaster 0 beralkohol rendah (12,25) dan berprolin rendah (510). Pusat dalam satuan asli memberi profil yang mudah dibaca.
Dengan kata sederhana: Dengan melihat pusat dalam satuan asli, tiap klaster bisa diberi ciri: klaster 2 "kuat" (alkohol, flavanoid, dan prolin tinggi), klaster 1 flavanoid rendah, klaster 0 alkohol dan prolin rendah.
Langkah 3: memeriksa sifat algoritma
| kmeans.py | |
|---|---|
Z[km.labels_ == k].mean(axis=0) mengambil semua sampel di klaster k (syarat boolean pada baris) lalu merata-ratakannya per fitur (axis=0). Hasilnya dibandingkan dengan km.cluster_centers_.
Hasil. Selisih maksimum 7×10⁻¹⁶ (nol akibat pembulatan): pusat klaster memang sama dengan rata-rata anggotanya, sesuai definisi algoritma.
Langkah 4: sensitivitas terhadap inisialisasi
Konsep. k-Means hanya menjamin optimum lokal; titik awal yang berbeda dapat memberi hasil berbeda. n_init=1 dan init="random" memperlihatkan efek ini.
Perulangan menjalankan k-Means satu kali per seed dengan pusat awal acak.
seed  inertia  ARI   (init acak, n_init=1)
0     1280.0   0.880
1     1277.9   0.897
2     1277.9   0.897
3     1277.9   0.897
4     1282.5   0.846
Interpretasi. Tiga seed (1, 2, 3) menghasilkan inertia terbaik 1277,9 (ARI 0,897), tetapi seed 0 menghasilkan 1280,0 (ARI 0,880) dan seed 4 menghasilkan 1282,5 (ARI 0,846): optimum lokal yang lebih buruk. Karena itu n_init=10 (bawaan) dan k-means++ dipakai.
Dengan kata sederhana: Menjalankan k-Means sekali dengan titik awal kurang beruntung bisa memberi hasil yang lebih buruk. Mengulang beberapa kali dan mengambil yang terbaik (n_init) adalah pengaman sederhana.
Langkah 5: keterbatasan pada klaster non-bulat
| kmeans.py | |
|---|---|
make_moons(n_samples=400, noise=0.08, ...) membuat data sintetis berupa dua bulan sabit yang saling mengait; ym adalah kelompok sebenarnya. k-Means dengan 2 klaster dijalankan pada data ini.
Interpretasi. ARI hanya 0,233: k-Means memotong ruang dengan batas lurus dan mengasumsikan klaster bulat, padahal bentuk data melengkung. Algoritma berbasis kepadatan seperti DBSCAN cocok untuk bentuk seperti ini.
Dengan kata sederhana: k-Means selalu membuat kelompok "bulat". Pada data berbentuk bulan sabit ia memotong lurus dan salah. Jika bentuk kelompok tidak bulat, coba DBSCAN.
Langkah 6: gambar
Data Wine memiliki 13 dimensi sehingga tidak dapat digambar langsung. PCA(n_components=2) memproyeksikannya ke dua komponen utama (arah dengan variasi terbesar) hanya untuk visualisasi; klastering tetap dilakukan pada 13 fitur. Dua grafik berdampingan diwarnai menurut klaster k-Means dan menurut kultivar sebenarnya.
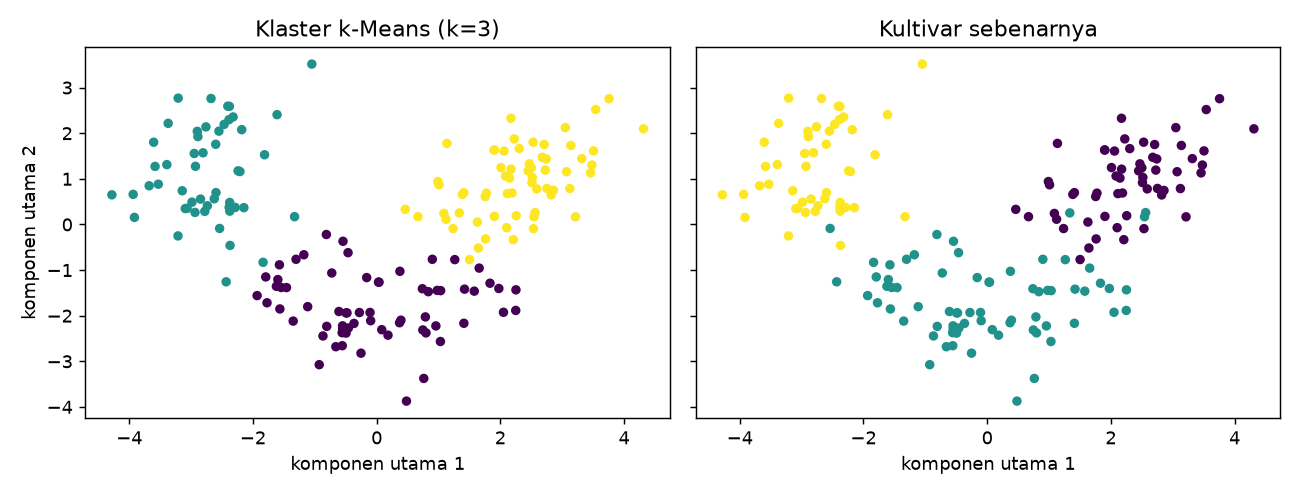
Cara membaca. Sumbu-x dan sumbu-y adalah komponen utama 1 dan 2 (tidak punya satuan alami); tiap titik satu anggur dan warna menunjukkan kelompok. Pola warna di kiri sangat mirip dengan kanan, konsisten dengan ARI 0,897. Tumpang-tindih di perbatasan menjelaskan mengapa ARI tidak 1.
Program lengkap (kmeans.py)
Kesalahan umum
Hindari
- Memakai k-Means tanpa scaling.
- Satu kali inisialisasi (
n_init=1) lalu menerima hasilnya. - Menganggap k-Means selalu menemukan klaster "sebenarnya".
- Memakai k-Means pada klaster non-bulat atau data dengan banyak outlier.
- Memilih \(k\) sembarang (lesson berikutnya).
Latihan
- Jalankan dengan
k=2dank=5. Bagaimana inertia dan ukuran klaster? - Bandingkan
init="random"dan"k-means++"dengann_init=1pada 20 seed. - Coba
MiniBatchKMeansdan bandingkan hasil dan kecepatannya.
Ringkasan
k-Means mengalternasi penetapan dan pembaruan pusat untuk meminimalkan inertia. Wajib scaling, gunakan n_init yang cukup, dan ingat asumsi klaster bulat.
Berikutnya: DBSCAN.